情報速度と投資アルファ
多くの情報依存型ビジネスモデルの収益性低下
ジップの法則とシャノンの情報エントロピーは、異星生命の発見を助けることができます
私たちは話しました how machine learning companies use data to recognise text そして investors use data to pick companies.
今週は、科学者たちがどのようにデータを活用してエイリアンを探しているかについて話しましょう。以下の内容の一部は以下のものから引用します Laurance Doyle’s talk with the Long Now group.
地球外知的生命体研究所(SETI)の探索は、異星生命を探す研究機関の中で最も有名なものです。その使命は “to explore, understand and explain the origin and nature of life in the universe and the evolution of intelligence.”
そもそも、どうやってそんな問題をスコープ化すればいいのでしょうか?
もし異星生命体を探すなら、彼らはどこか別の惑星に存在しているはずです。つまり、惑星を探すことが出発点になる可能性があるということです。
初歩的な科学からも、惑星は星の周りで形成されることがわかっています。したがって、惑星を支えられる星を見つけることも重要なポイントであることがわかっています。
ほとんどの惑星は過酷な環境を持っていることはわかっています。ですので、そのリストは生命を支えられると考える惑星に絞りましょう 1.
その惑星のうち、すべてが実際に生命が現れるわけではないので、実際に生命が現れる割合を考えてみましょう。
ここで十分に機能があり、検索を始めるのに十分な機能があると思えるかもしれません。それでも、検索精度を絞るために追加できる機能はいくつかあります。
惑星を見るときは、惑星から信号が出ているかどうかが重要です。そうすれば、その惑星に生命が存在するというより強い証拠になります。例えば、誰かが音楽を演奏している家を見ている家を見ていると想像してみてください。後者のシナリオでは、生き物が存在すると結論づける方がずっと簡単です。
では、生命が実際に現れる惑星と「知的」な種族が現れる惑星を絞り込みましょう。
そしてその「知的種」の中で、通信技術を発展させる種族だけを挙げましょう。
最後に、たとえその種が通信を発達させたとしても、もし彼らが生きていなくなって通信を送ることができなければ、私たちは決してそれを受信できません。ですから、それらの文明がどれだけ長く生きているかも考慮する必要があります。
それはかなりの量でした。しかし今や、問題を枠組み化し、信号を送れる知的異星文明の数を探すために必要な主要な要素がすべて揃っています。
これらすべてを総合すると、私たちが考え出したのは Drake equation知的生命体を推定する有名な方法 2.今回触れたすべてのポイントを掛け合わせて、どれだけの賢いエイリアンがいるかを推測しているのに注目してください:
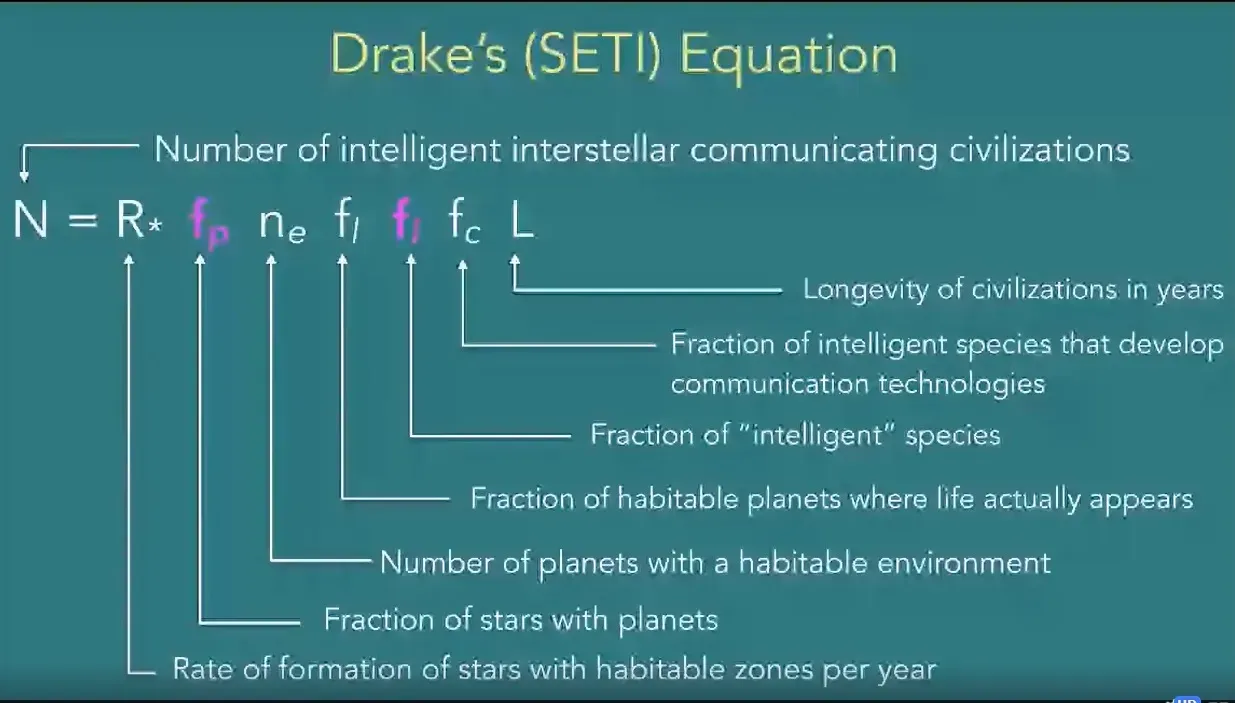
ただし、それは多くの変数なので、今日はその方程式の一部、つまり「知的」な種の割合に焦点を当てましょう。
「知的」な信号と「知能のない」信号を区別する方法を見つける必要があります。例えば、マイクで歌うことと歌うことを区別したいと思います audio feedback.
もし異星人の通信の例があったり、何を探しているのか分かっていたら助かります。明らかに前者はいません 3しかし、後者をさらに絞り込む方法もあります。私たちが見つけたいのは、知的信号がランダムノイズと対照的に持つ特性です。
その一つの方法は、私たちの周りにある非人間知的生命体を観察することです。 We use Antarctica as a proxy for Mars, 同様に動物を異星語の代理として使うこともあります。
もし知的なコミュニケーションが守るべきだと考えるルールがあれば、それを動物のコミュニケーションと照らして、どれだけ効果的かを検証できます。これにより、検索基準を広げるか絞るべきかがわかります。
言語理論には2つの主要な法則があることがわかりました。ジップの法則とシャノンの情報論エントロピーです。それぞれ順に見ていきましょう。
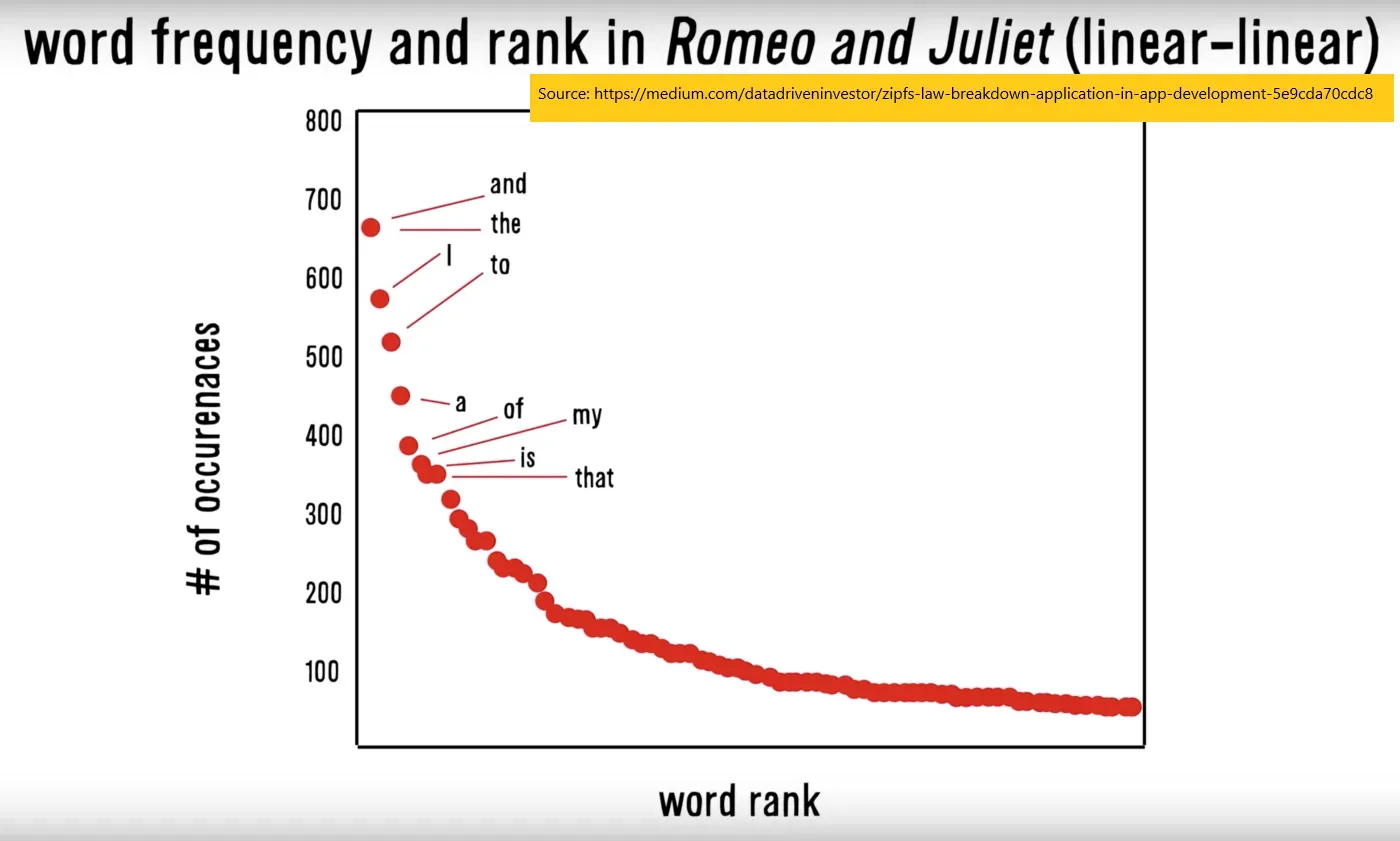
ジップの法則は、すべての言語において、単語の出現頻度は単語の順位に逆比例するということです。すべての単語を出現頻度でランク付けした場合です。例えば、「the」が最も一般的な単語であれば、そのランクは#1です。「I」が2番目に多い単語であれば、ランク#2です。ランク#1の単語「the」は、ランク#2の単語「I」の2倍の回数で言語内で出現します。この単語はrunの#3単語の3倍の頻度で言語内で現れます。
このような法則があれば、その言語のサンプルテキストで検証できます。例えば、『ロミオとジュリエット』の単語の頻度をプロットした人がいます:
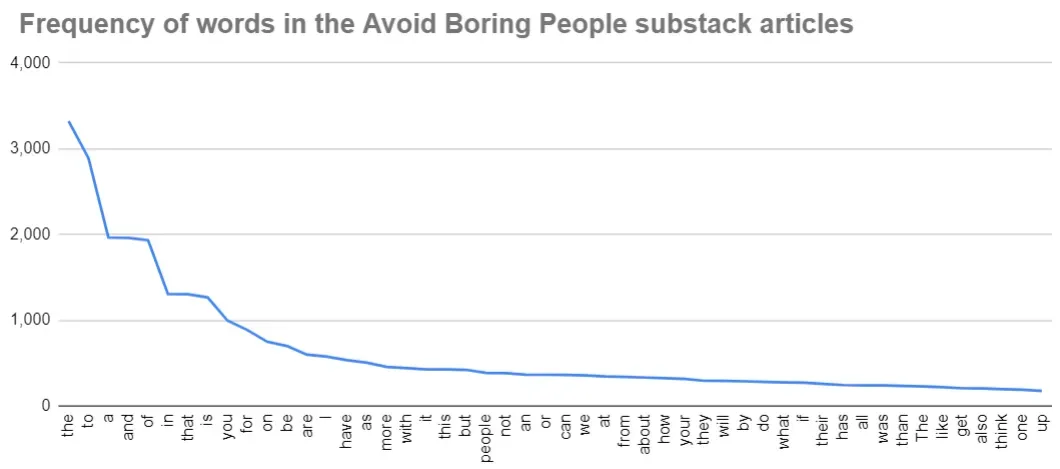
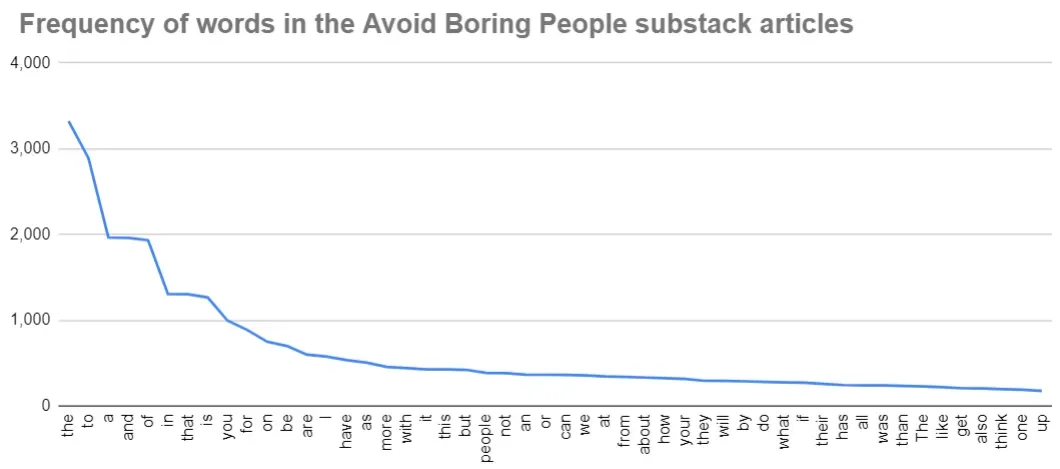
インターネットの見知らぬ人に頼るのに満足せず、自分のニュースレター投稿を分析してみました。簡単なPythonコードで 4私はすべてのサブスタック投稿からテキストを抽出し、使った上位50語を抽出して、それらの頻度に対してグラフ化しました。この関係は完璧ではありませんが、ジップフの法則が予測するものにかなり近いです。ご想像の通り、「the」「to」「a」「and」「of」は頻繁に現れます。
よし、これで一つの法則ができた。イルカやクジラのような動物に対してそれを試してみて、まだ有効かどうか確かめられる。 Researchers did that, そして、その通りだとわかりました! 5 言い換えれば、ジップの法則は異星言語にも適用される可能性が高いのです。宇宙からの信号に適用することで、ノイズの一部を除去できます。
シャノンの情報理論 6 他の単語の前に単語を知っておくことで、その単語が何かの手がかりが得られると提案しています。言い換えれば、文中の単語はそれぞれの単語によって異なります。例えば、前の文はおそらく十分理解できているでしょうが、最後の単語「other」を省略しました。
言葉の間に何らかの関係があることを知っているからこそ、 we can also derive a way to score the language based on those relationships. 私は数学については自分では理解できないので手放しにしていますが、私たちが理解できる主なポイントは、言語にはスコアがあるということです。
これらのスコアをプロットすることで、ほとんどの言語がどの範囲に属するかを把握できます。以前と同じプロセスでイルカやクジラのスコアリングを行い、それらの言語がどのように機能するかも確認できます:
ご覧の通り、ほとんどの言語には一定の範囲があります。同じスコアリングシステムを信号に適用すれば、言語である可能性が低いものも除外できます。
私たちは大きな目標を持ってスタートしました――エイリアンを見つけること。
その後、問題の枠組みを作り、参考になりそうな様々な要素を考え出しました。
問題の一部に絞り込み、検索の精度を高める方法を模索しました。人間の言語から2つの主要な基準を導き出し、それを他の非人間の言語と照合しました。今後は、同様のアプローチでさらに研究したい信号を絞り込むことができます。
もしこれがすべて仮定の話だと思っていたなら、上記のアプローチは exactly what one team at SETI is using to analyse signals.
ご覧の通り、このプロセス自体は他のデータ分析の問題と似ていることがあります。まず、目標を決めます。次に、自分が必要かもしれないものを枠組みにします。次にアルゴリズムを考えます。最後に、それが通用するかテストします。ある分野の問題解決は、別の分野での問題解決とそれほど違いはありません。
居住可能とそうでないものの定義 is difficult of course, 私たちに合う方法が宇宙生命に当てはまるとは限りません。ただし、炭素ベースの生命(私たちがそうであるもの)ではなく、シリコンベースの生命を信じる人もいるかもしれません there are difficulties with that assumption ↩
「ドレイク方程式の有用性は解くこと自体ではなく、科学者が他宇宙の生命を検討する際に取り入れなければならないあらゆる概念を熟考することにあり、他の場所での生命の問題に科学的分析の基盤を与える」ことに注目してください ↩
もしあなたが私に知らない何かを知っているなら、もっと知りたいです… ↩
簡単というのは、書くのに<30分、トラブルシューティングに3時間かかったという意味です。コードは here もし自分の目的に合わせてアレンジしたいなら、 ↩
また、人間とイルカの赤ちゃんの赤ちゃんのおしゃべりともテストしました。しかし、どちらもジップの法則には従わないことが分かりました。 ↩
はい、こちらです その Claude Shannon, the guy who essentially taught us how to create electronic communications ↩
多くの情報依存型ビジネスモデルの収益性低下
より多くの情報を持つことで、より良い投資判断が下せるのでしょうか?
市場概要、リスク、競争環境