人体工学性:这意味着什么?
为什么集合平均和时间平均的差异对投资和风险很重要

我们大多数人都曾在统计学课上学习过p值。大多数人认为那时已经理解得够多了;毕竟我们通过了这门课。我们大多数人都错得很离谱。
由于p值被广泛滥用, some scientists are speaking out against the application of p values in research:
我们并不呼吁禁止P值。我们也不是说P值不能作为某些专业应用中的决策标准(例如判断制造过程是否符合某种质量控制标准)。我们也不是主张“随意”的局面,即薄弱的证据突然变得可信。相反,正如几十年来许多其他观点一样,我们呼吁停止以传统、二分法的方式使用P值——用来判断结果是反驳还是支持科学假设
作者要求改变人们对p值的看法,认为它是决定研究结果是否被接受的“唯一因素”。他们继续阐述了他们的理由,并概述了一些替代方案,稍后我会详细说明。
不过首先,为了更好地理解他们的主张,我们应该回顾一下 what p values are 1:
衡量结果在假设实验(包括不存在效应)时的惊讶程度。P值是否高于或低于定义“统计显著性”的任意阈值(如0.05),决定假设是否被接受、论文发表及产品是否上市。
所以我们对结果做一些数学计算,得到一个数字X,然后如果我们的数字X是<0.05,就拒绝我们的原假设,这意味着我们的备选假设具有可信度 2.这个过程看起来很机械,但还是可以理解的。问题在于如何解读我们刚刚做的事情。X是你拒绝原假设时犯错的概率吗?X是你接受备选假设时你错的概率吗?1 - X是你正确的概率吗?
以上任何一种解释都不正确,说明了统计数据可能不直观,以及原因 not even scientists for meta-science can explain what p values mean intuitively:
我们想知道结果是否正确,但p值无法衡量这一点。它无法告诉你效应的规模、证据的强度或发现是偶然的结果概率。
那么,你能从p值中获得哪些信息呢?我找到的最直接的解释来自劳拉和约翰·阿诺德基金会研究诚信副总裁斯图尔特·巴克。他说,想象一下,你有一枚硬币,你怀疑它偏向正面。(你的原假设是硬币是公平的。)你抛100次硬币,得到的正面多于反面。p值不会告诉你硬币是否公平,但它会告诉你你获得正面次数的概率,至少和硬币公平时一样多。仅此而已——仅此而已。
重要的是,你的p值是获得你得到结果的概率, 在假设原假设下.如果你的原假设是正确的,你只会得到X%实验中的结果。由于X是一个低数字,你假设原假设不太可能正确,并拒绝它。这并不能告诉你得到你所得到结果的概率 当不假设原假设时.
假设我们有一个实验,看看一群人的平均身高是否为0。如果p值非常低,我们会拒绝原假设,因为显然每个人的身高都是>0。然而,这并不能告诉我们在这个“真实世界状态”下,得到我们计算的平均身高的概率有多大。它只是告诉我们,我们得到这个平均身高的概率很低, 如果平均身高为0 3.
显然,p值比大多数人(包括我自己)所相信的简单是/否更为复杂 4.第一篇文章的作者接着说:
我们必须明确什么必须停止:我们绝不应仅仅因为P值大于阈值如0.05,或者等价地仅仅因为置信区间包含零,就断定“没有差异”或“无关联”。我们也不应因为其中一项结果统计显著而另一项没有,就断定两项研究相冲突。
对数百篇文章的调查发现,统计学上无显著性的结果大约有一半被解读为“无差异”或“无效应”
非显著统计结果并不等同于无效应。事实上,作者更倾向于避免使用“统计显著”一词:
我们同意,并呼吁放弃统计显著性的整个概念。
他们这样做的理由是,这种“是/否”重要性“的定义是一种错误的二分法:
问题更多是人性和认知层面,而非统计学上的:将结果归类为“统计显著”和“统计学上无显著性”,让人误以为这样分配的项目在类别上是完全不同的 \[…\]避免这种“双重偏见”的一个原因是,所有统计数据,包括P值和置信区间,在不同研究中自然存在差异,且往往差异出人意料地存在差异。事实上,仅凭随机变异就很容易导致P值之间的巨大差异,远远超出0.05阈值的两侧。
这对我来说很有道理,但似乎是一场艰难的战斗。在处理复杂决策时,人们想要简单的启发式方法,而p值提供了一种简单的理由来证明某些事情的合理性。
作者还讨论了使用置信区间时需要注意的一些事项 5:
首先,仅仅因为区间给出了与数据最兼容的值,基于假设,并不意味着区间外的值不兼容;只是它们兼容性较低。
其次,在假设下,并非所有内部值都与数据完全兼容。
第三,就像它来自的0.05阈值一样,计算区间的默认95%本身就是一种任意的约定。
最后,也是最重要的,要谦虚:兼容性评估依赖于计算区间所用统计假设的正确性。
他们最后提出了一个没有单一p值强调的世界的设想:
统计显著性退役将是什么样子?我们希望方法部分和数据表表能更加详细和细致。作者将强调他们的估计及其不确定性——例如,通过明确讨论区间的下限和上限。他们不会依赖显著性检验。当报告P值时,会以合理的精度给出(例如P = 0.021或P = 0.13)——不使用星号或字母等标注统计显著性,而非二元不等式(P < 0.05或P > 0.05)。解释或发表结果的决策不会基于统计阈值。人们将减少使用统计软件的时间,更多时间思考。
正如我之前写过的, beliefs are tricky,即使你坚信科学。实验是科学过程的关键部分,理解如何分析结果是其中的重要组成部分。对p值的误解导致了新闻报道时对研究的误解。遗憾的是,鉴于将p值解读为是非题更容易,我认为这种情况短期内不会改变。我不知道解决办法是否是降低p值的重要性,但提高对其误用的意识是有帮助的。
以下描述的文章也总结了Valentin Amrhein、Sander Greenland、Blake McShane开篇观点的主要论点 ↩
在初稿中我写了“接受我们的假设,否则拒绝它”,这对p值的理解是错误的。这说明犯错有多容易,我现在有点担心自己又犯了一个错误。 ↩
我觉得其他值得重新阅读的资源有 here 以及 here.除了讨论为什么p值与错误率不同,网站还有一个有趣的表格,展示了低p值可能导致高错误率:
| P值 | 错误拒绝原假设(即实际为真)的概率 |
|---|---|
| 0.05 | 至少有23%(通常接近50%)。 |
| 0.01 | 至少7%(通常接近15%) |
↩“这张表中较高的错误率让你感到惊讶吗?不幸的是,人们常将P值误解为错误率,这会造成一种比原假设有远超合理证据的错觉。如你所见,如果你基于一项P值接近0.05的研究来做决定,样本中观察到的差异在总体层面可能不存在。”
尽管我在高中和大学都修过多门统计课…这要么说明了这有多难,要么说明我理解某件事需要多长时间。 ↩
他们更喜欢用“兼容性间隔”这个词 ↩

为什么集合平均和时间平均的差异对投资和风险很重要
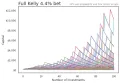
利用数学估算最佳投资组合规模
随机看起来并不随机